[NIPS 2025] Bioreason 논문리뷰
https://doi.org/10.48550/arXiv.2505.23579
BioReason: Incentivizing Multimodal Biological Reasoning within a DNA-LLM Model
Unlocking deep and interpretable biological reasoning from complex genomic data remains a major AI challenge limiting scientific progress. While current DNA foundation models excel at representing sequences, they struggle with multi-step reasoning and lack
arxiv.org
DNA Foundation model이란, DNA raw 서열을 이용해서 다양한 downstream task에 대해 예측하는 등, DNA 서열로부터 representation vector를 형성하고 이를 활용하는 모델들을 의미한다. 그러나 이런 DNA foundation 모델들은 representation capture는 상당히 잘 하지만, black box라서 해석이 불가능하다.
LLMs는 복잡하고 정교한 training step을 거쳐야 하지만, 최근들어 거의 모든 분야에서 상당히 정교하게 작동하고, 특히 CoT를 이용해 어떻게 그런 결론이 났는지를 해석 가능하도록 Reasoning 해준다.
저자들은 이 두 모델의 장점을 섞어 BIOREASON, 생물학 데이터를 다루면서 어떻게 그런 결론이 났는지를 해석까지 하기 위해 DNA Foundation model과 LLMs을 통합시킨 모델을 제안한다.
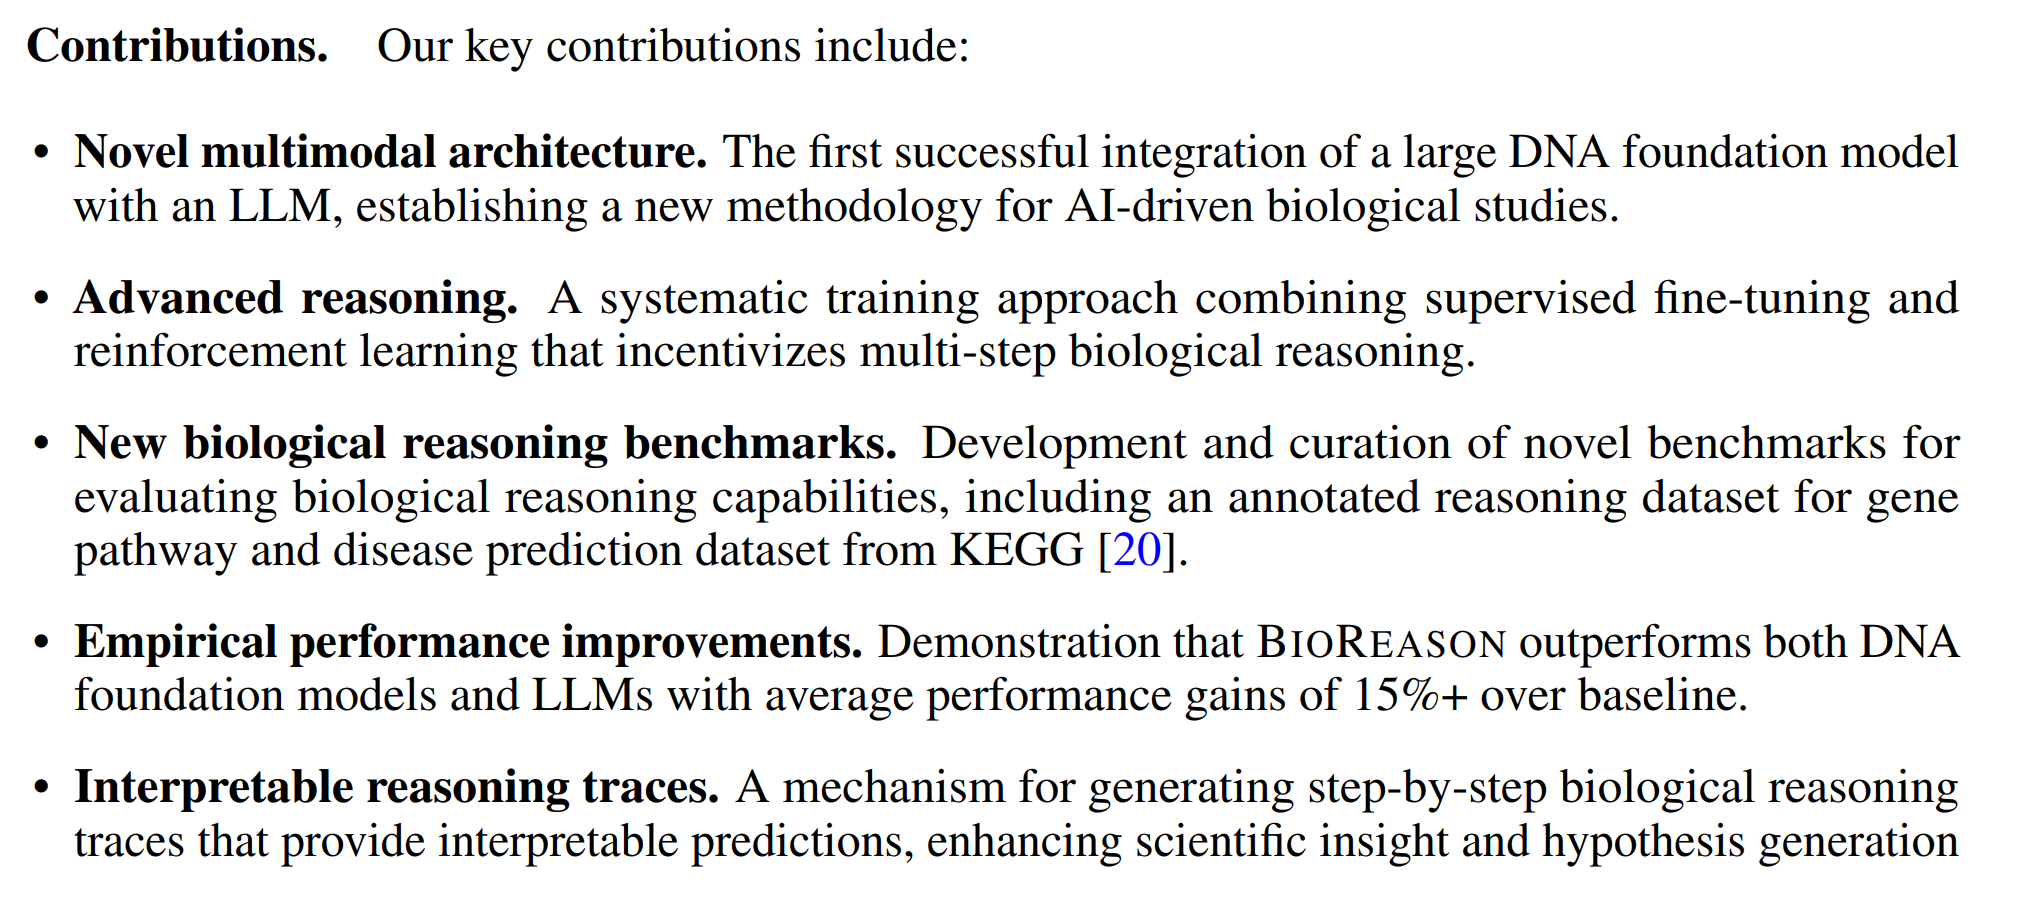
특히 두번째 Advanced reasoning을 보면, Supervised Fine-Tuning(SFT)과 강화학습을 통해서 성능을 끌어올렸다는데, 어떻게 학습했는지, 학습 전략을 자세히 들여다 볼 필요가 있겠다.
Genomics BenchMarks
DNA Foundation 모델들을 평가하기 위한 benchmark들은 대부분 prediction model이고, regulatory element identification, variant effect prediction, transription factor binding site prediction, splice site classification 등이 있다고 한다. DNA Foundation 모델을 평가하기 위한 다양한 downstream task들을 정리하고 비교방법을 제시한 2024년 ICLR의 Bend[1]를 참고해보자면, 정립된 프로세스를 제공한 것은 좋지만, 모든 task가 앞서 언급했듯 어떻게 그런 결과를 추론해 냈는지, Reasoning process 자체는 전혀 평가하지 못한다는 단점이 있다. 따라서, 본 연구는 KEGG를 이용해서 Multi-step reasoning과정 자체를 평가할 수 있도록 따로 benchmark 데이터를 만들었다.
3. BIOREASON 모델은 Genomic 데이터와 Language 데이터를 통합해서 interpretable한 biological reasoning을 도출하는 것을 목표로 하였다.
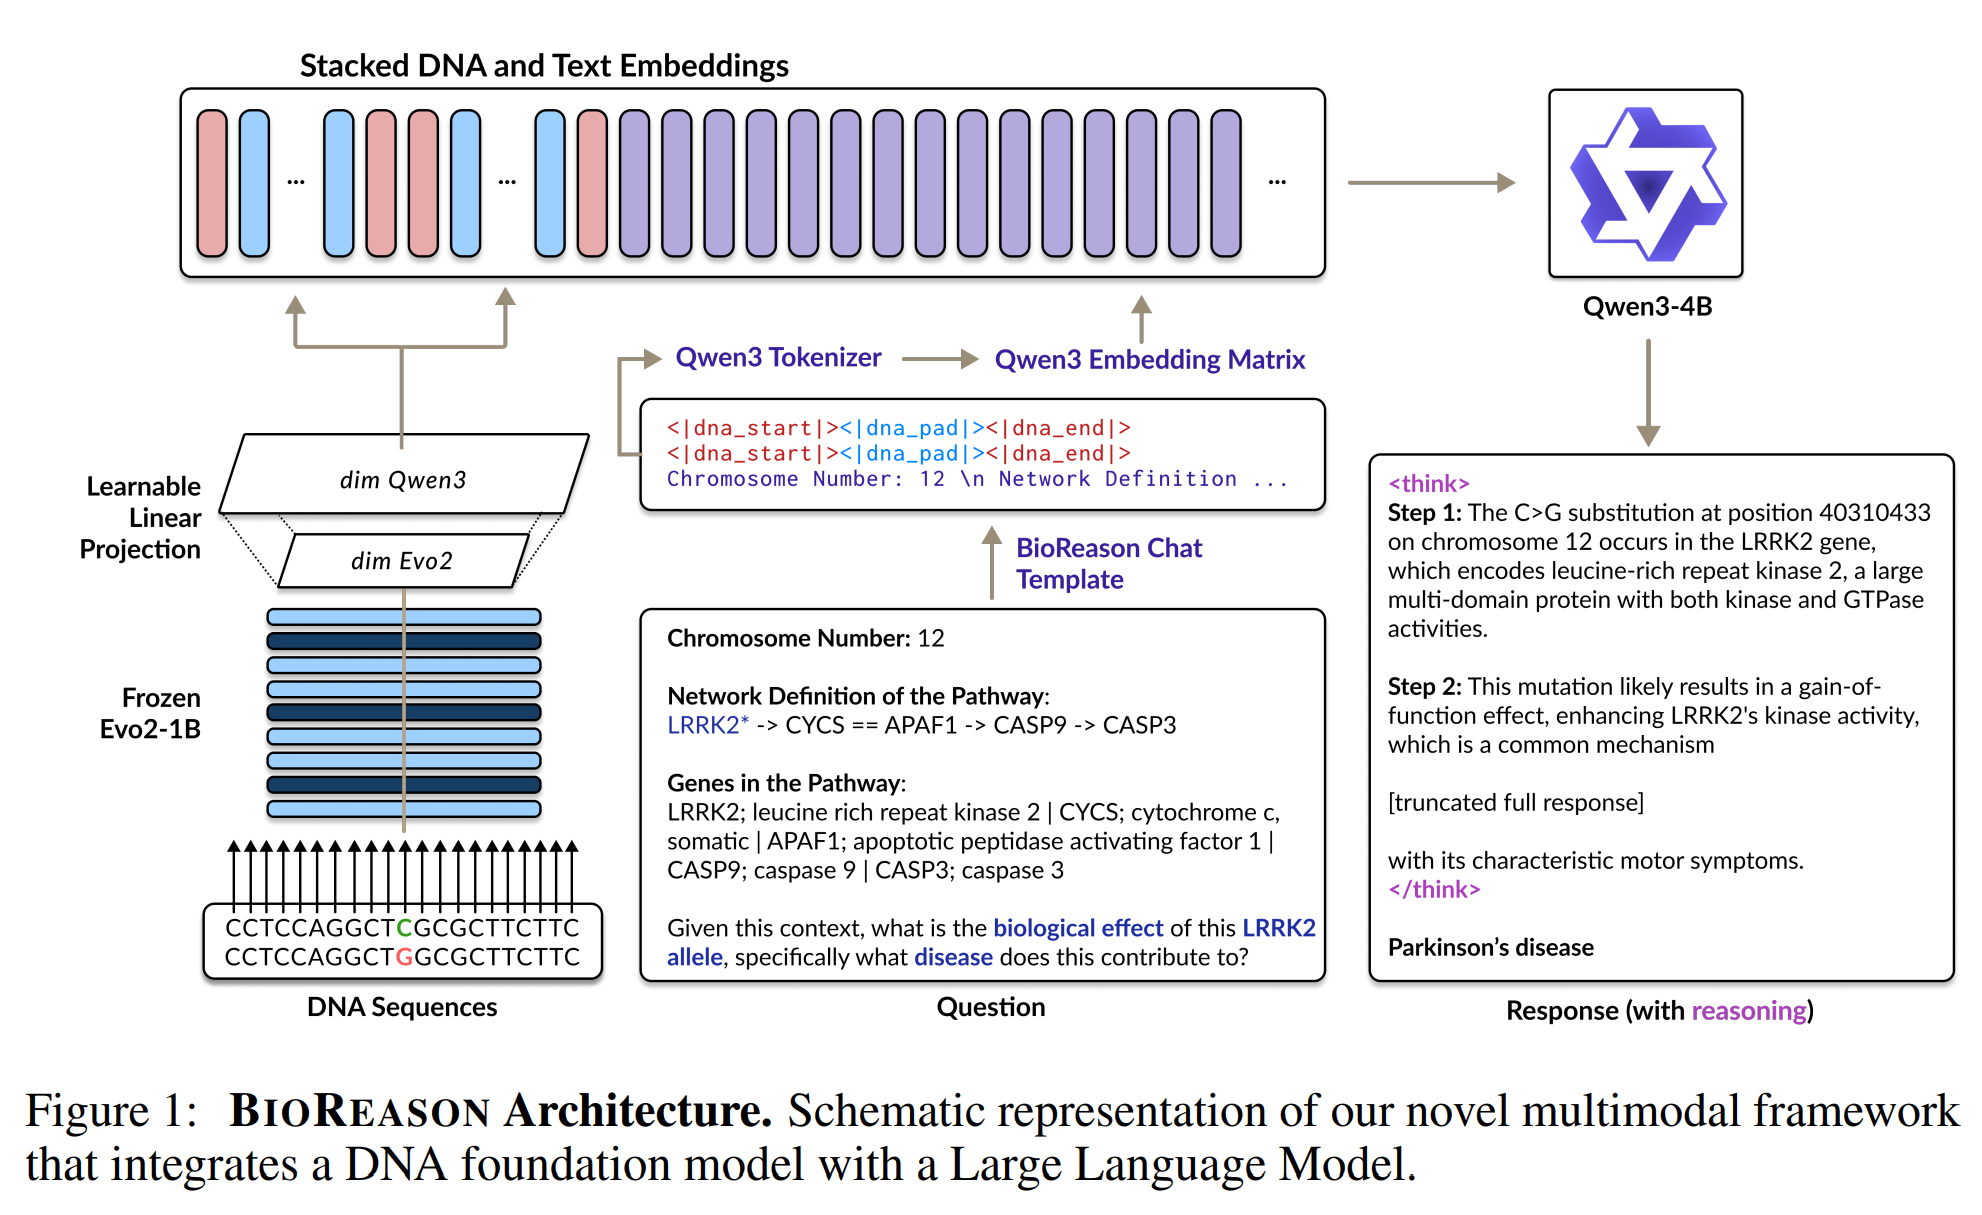
두 가지 main input이 있다. i) DNA sequence(SDNA), ii) Textual Quaries (QTEXT)
쿼리 (QTEXT) 들은 사용된 LLM(Qwen3.0 모델을 사용한 듯)의 Vocabulary (VLLM)으로부터 Tokeninzation 되어 M개의 Token sequence로 표현된다.
(w1, ..., wM) = TLLM(QTEXT)
각 토큰 w는 LLM의 Embedding dimension에 맞춰 Embedding Layer를 구성한다.
EQTEXT = (E(w1), ..., E(wM))
문제는 Quary Text 같은 경우는 Natural Language로 되어있기 때문에 Qwen3.0으로 Embedding 하면 되지만, DNA Sequence 서열의 경우는 Natural Language가 아니라서 Qwen으로 무지성 Embedding 하는 경우 전혀 맞지 않는 representation vector를 뱉어내게 되는 것은 자명하다. 따라서 저자들은 DNA representation을 따로 DNA Foundation 모델로부터 얻어서 Tokenization된 QTEXT와 통합시킨 서열인 XLLM을 구축하는 전략을 구현했다. XLLM을 입력받은 Core LLM 모델은 YOUT을 출력하고, YOUT = (y1, ..., yK) 형태의 추론 과정을 나타내는 토큰집합이며 Final Response를 함께 return한다.
3.1 DNA Foundation 모델
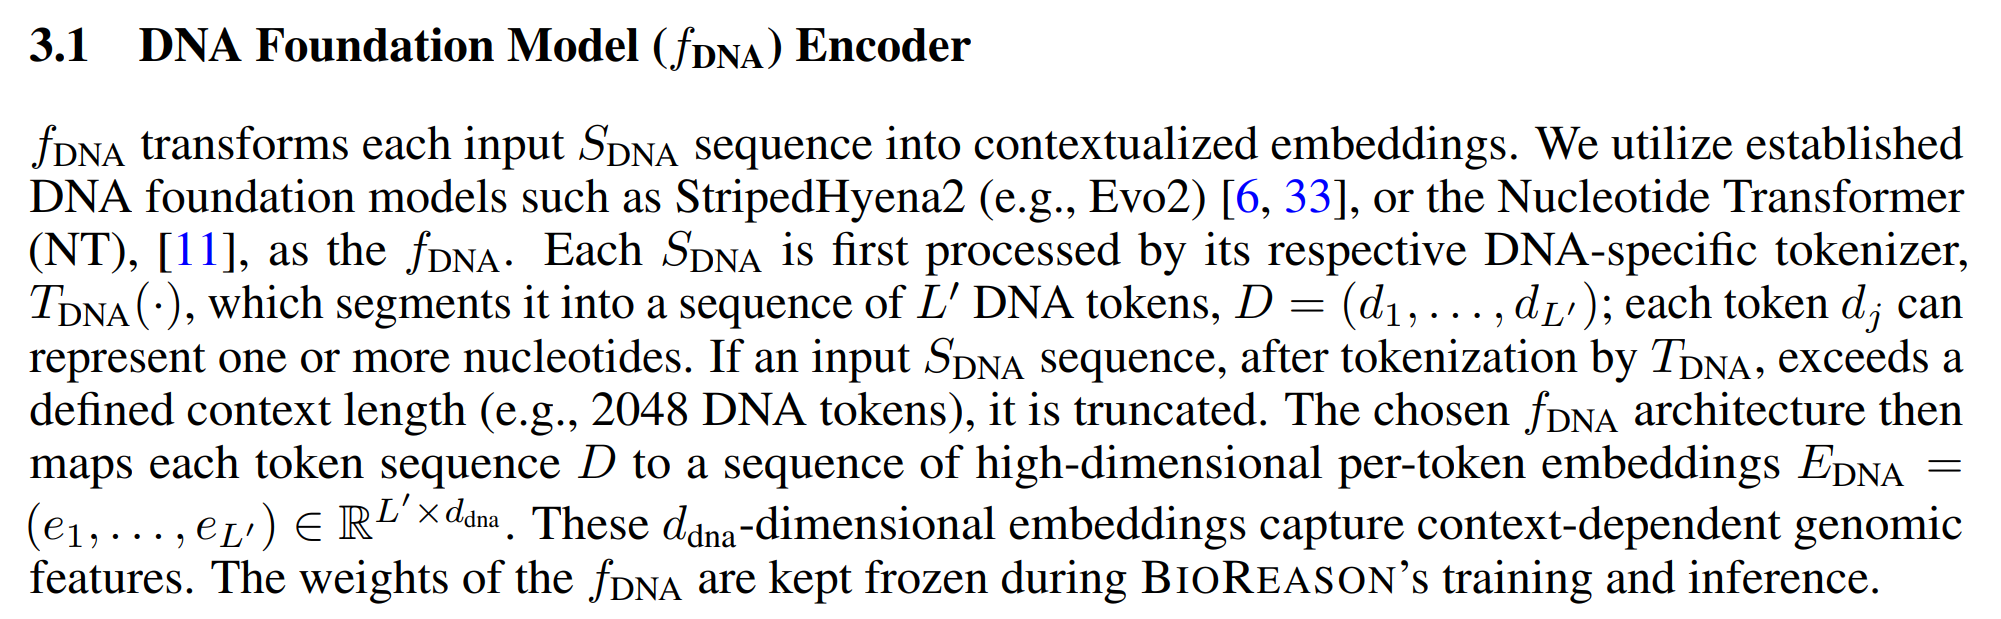
SDNA를 받아서 Embedding vector로 return 해줄 수 있는 Foundation 모델을 fDNA로 명하고, 실제 사용된 모델은 Evo2[2]와 Nucleotide Transformer (이하 NT)[3]를 사용하였다. DNA Foundation 모델은 단순히 DNA 서열의 Embedding만 얻기 위한 모델이므로 학습 과정에서 Freezing된다.
자세한 Embedding 구현과정은 수식입력이 불편한 티스토리 블로그라는 이유로 그냥 귀찮으니 이미지로 대체
3.2 Core LLM 모델 (fLLM)
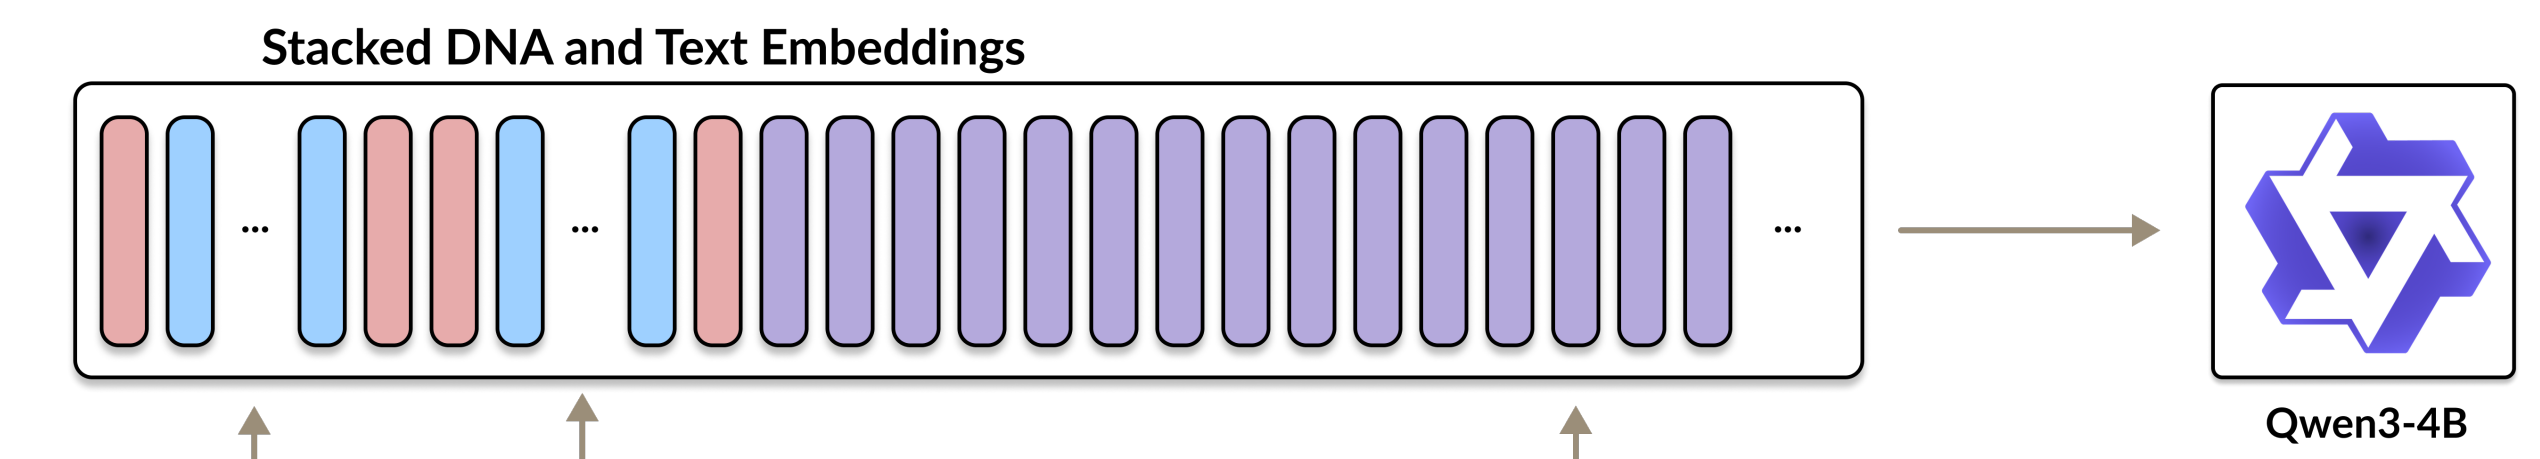
XLLM embedding vector를 입력받아 YOUT을 출력하는 LLM 모델이 Core LLM(fLLM)이고, Qwen3.0을 사용했으며, 다양한 special token들이 사용되었다.
3.3 Mulitmodal Genomic Integration
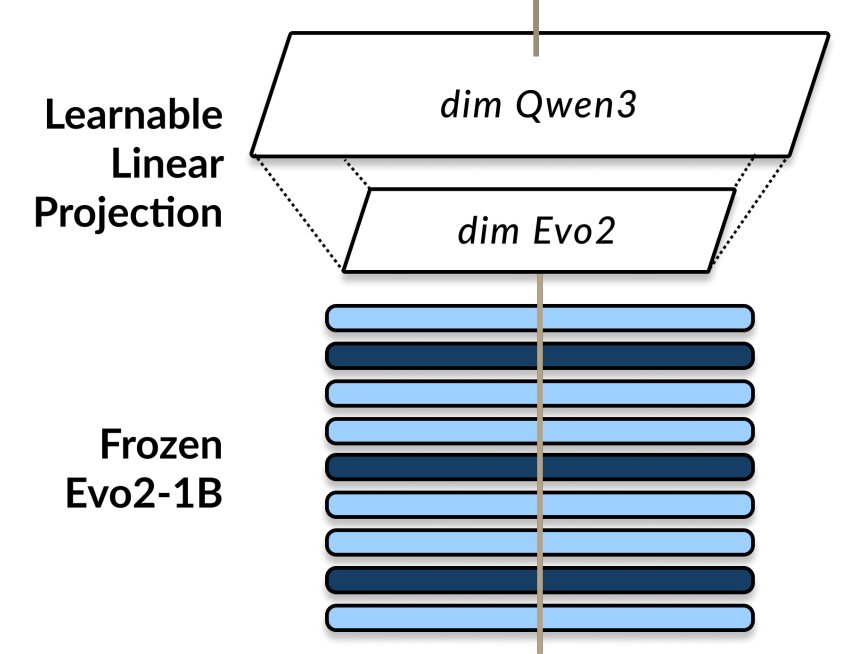
DNA Foundation 모델에서 얻어진 SDNA Emedding vector는 fDNA의 임베딩 사이즈(Rdna)로 출력될텐데, 이것을 그대로 Core LLM인 Qwen에 input할수는 없다. 따라서 학습가능한 Linear projection layer를 통해서 Qwen에 입력 가능한 Embedding vector의 Dimension(Rllm)으로 맞춰준다. (Proj: Rdna ↦ Rllm)
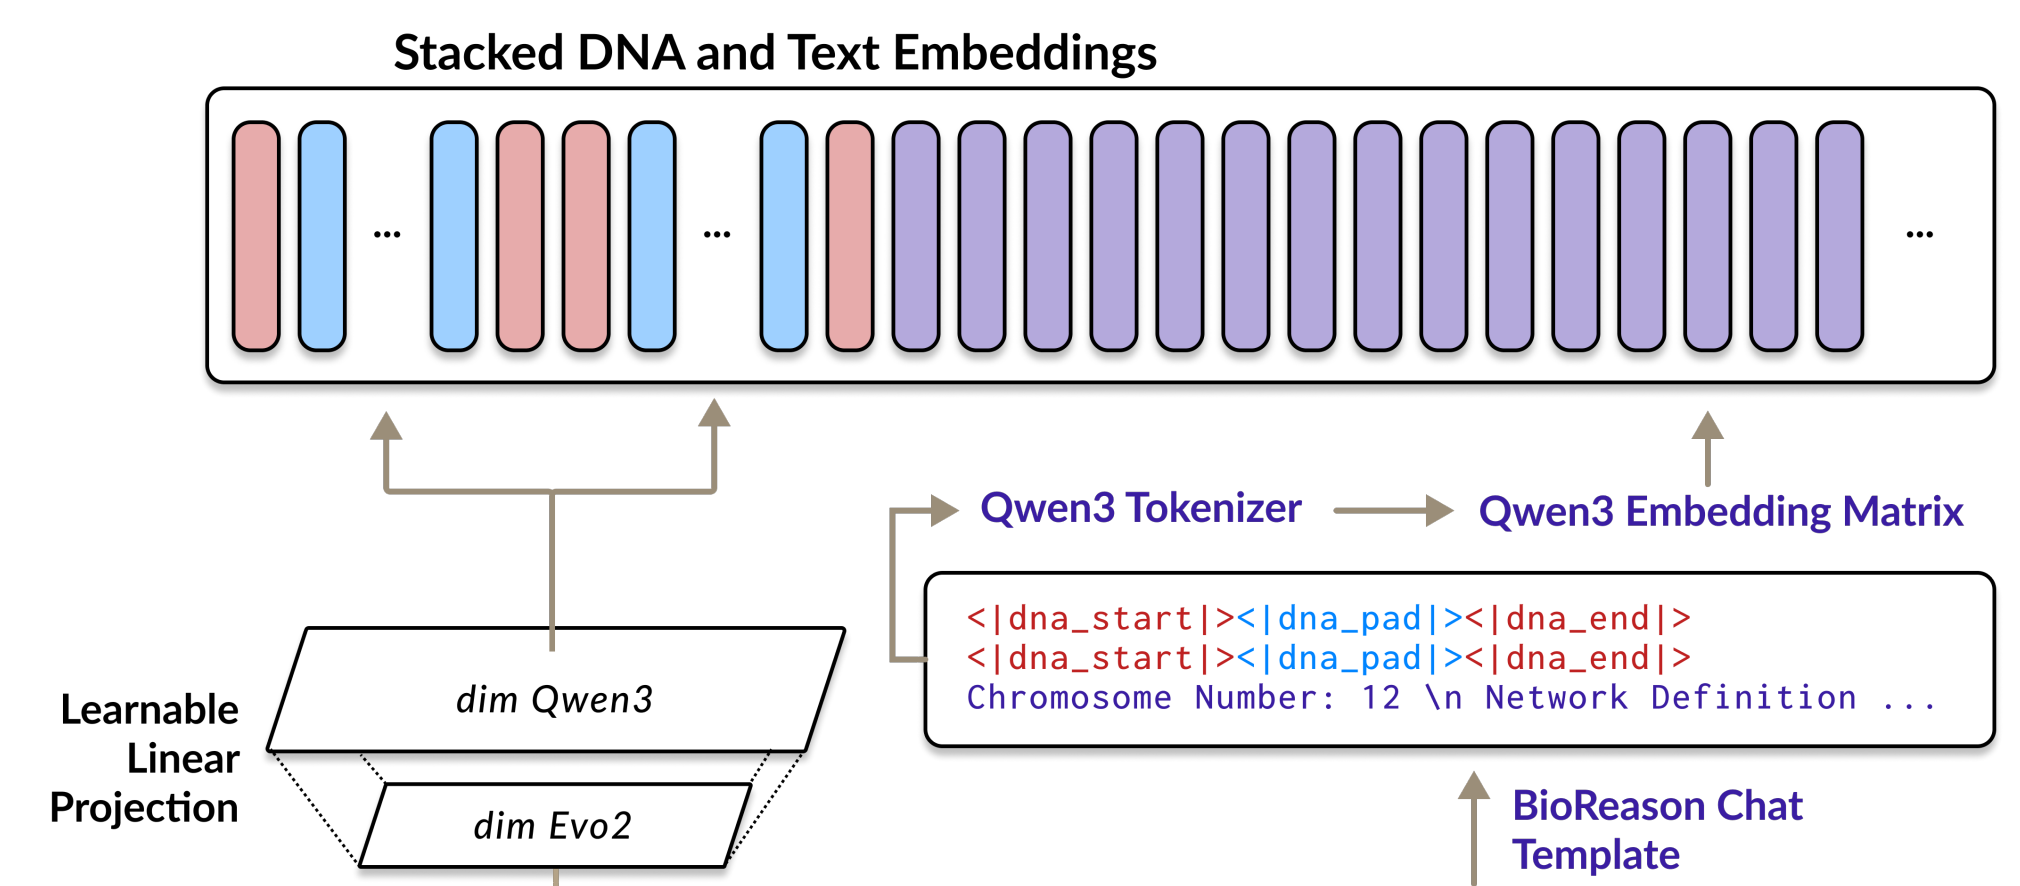
그다음은 그냥 Embedding size가 동일해진 QTEXT와 SDNA의 Embedding vector를 concat한다(stacking) 이게 Core LLM(Qwen3.0 = fLLM)에 들어갈 완성된 input (XLLM)이 된다. 모든 XLLM들은 Positional Informative를 전달받기 위해 RoPE[4]가 사용되었다.
3.4 Group Relative Policy Optimization (GRPO)
보통 Reasoning을 목표로 하는 LLM 모델을 학습시킬때, 추론 과정까지 정답이 있는 supervised learning을 하는 것은 사실상 불가능하다. (그런 데이터가 있을리가 없기 때문에) 따라서, 필연적으로 강화학습을 사용할 수 밖에 없는데, Deepseek에서 사용한 GRPO 방식, 그리고 GRPO에서 발견된 문제를 조금 더 가다듬은 Dr.GRPO 방식이 순차적으로 발표되었는데 본 연구에서는 Dr.GRPO를 사용해서 추론과정을 학습시켰다. GRPO를 전부 다루기엔 너무 길어지므로 그냥 추론과정을 학습하기 위해서 Dr.GRPO를 사용했구나 정도로만 이해하고 넘어가도록 하자.
4. Datasets
본 연구의 Main Contribution중 하나는 KEGG로부터 어떻게 새로운 Benchmark 데이터를 구성했느냐를 파악하는 것이다.
세 가지 데이터 세트가 준비되었으며 하나는 novelty가 있는, 특히 reasoning 을 학습하기 위해 KEGG로부터 새롭게 구축된 데이터세트이고, 나머지 두개는 기존 구축되어있는 데이터를 조금 modify해서 구축한 데이터로 ClinVar와 OMIM으로부터 구축되었다.
특히 KEGG 데이터는 KEGG pathway에 추가로 ClinVar, OMIM, dbSNP, COSMIC 등의 다양한 annotation을 제공하는 bio-based DB의 데이터를 추가로 사용하였다.
4.1 How to Construct KEGG BenchMark
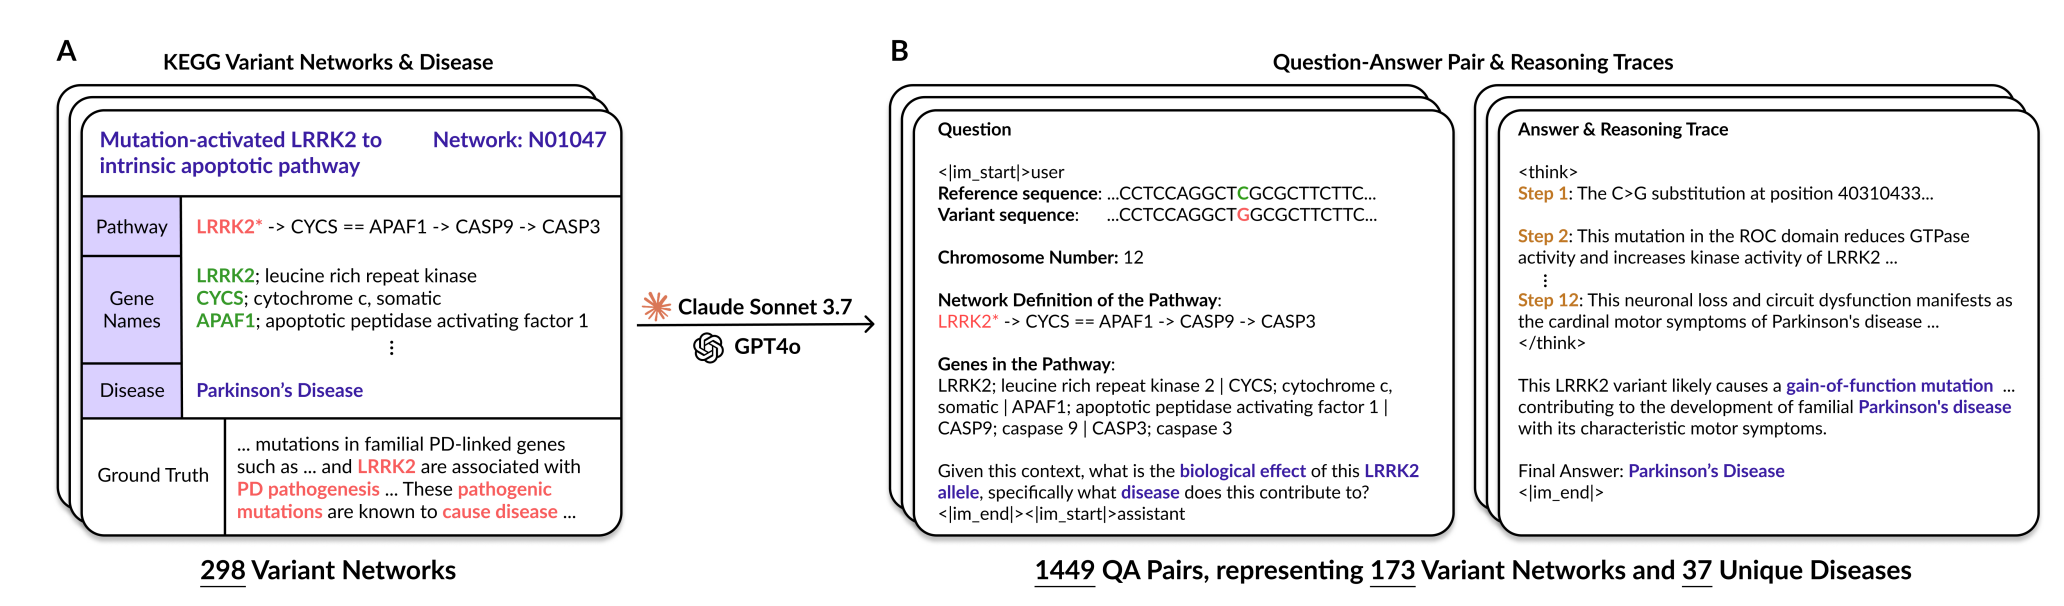
KEGG pathway DB로부터 1449개의 유전적 Variants와 그에 연관된 질병 표현형(Phenotype)의 연결관계를 정리해둔 entries를 구축하였다. 구조화된 KEGG DB의 데이터들과 Variants들의 관계를 step-by-step으로 reasoning할 수 있도록 multi-stage process를 통해서 구축하였다.
KEGG로부터 pathway network를 추출 ↦ Variant Information From Clinical DB (ClinVar, dbSNP, OMIM, COSM)들로부터 data augment (semi-automated mapping protocol을 사용[5, 6]) ↦ Activation, Inhibition, Complex Formation, Transcriptional Regulation 등의 interaction type을 제공하는 Molecular network 구축
Reasoning Pathway Construction and Curation
이 데이터의 가장 중요한 특징은 Molecular Mechanism 정보를 이용해서 Genetic Variants와 연관된 질병 표현형을 연결한 reasoning path를 포함하고 있다는 것이다. 이런 reasoning path는 KEGG DB의 질병 정보와 클로드 3.7 Sonnet 모델을 이용해서 구축되었으며 train-validation을 위해서 데이터는 Question-Answer 형태의 정형화된 쌍으로 구축되었다. (문제는 정작 어떻게 데이터를 만들었는지는 Appendix에도 구체적으로 제시되어있지 않다. LLM 프롬프트라던가 어떻게 Q-A 쌍을 만들었는지를 구체적으로 설명하지 않고 이렇게 대충 '클로드 3.7로 Q-A pair 만들었어요' 하고 넘어가도 될 일인가 싶다.)
4.2 Variant Effect Prediction of Coding Sequences
Coding Sequence는 인간을 구성하는 DNA에서 실제로 단백질 등으로 발현되는 유전자를 포함하고 있는 지역을 의미한다. 4.2절은 Single Nucleotid Variants(SNVs)만을 데이터로 다룬다.
GPN-MSA라는 연구로부터 데이터를 가져왔다. Variant가 생긴 Gene Name과 그에 따른 질병의 표현형을 ClinVar XML records로부터 추출했다. Benign(질병과 관련없는) Variants의 경우는 gnomAD v3.1.2로부터 추출했다. 기준은 allele number >=25000, Minor Allele Frequency (MAF) > 5%)

얻어진 데이터는 Chromosome 8을 제외하고는 전부 training용으로 사용하였고 test용으로 Chr8을 사용하였다. GPT-4o를 이용해서 각 샘플당 서로 다른 50개씩의 Question을 생성하였고, 병원성/비병원성 분류를 위한 훈련 및 테스트 데이터로 사용되었다. chromosome과 gene context를 이용해서 Conditional disease phenotype prediction도 훈련하였다.
아쉬운 점은 Appendix에 데이터들의 예시를 좀 보여줬으면 어땠을까 함, 말로만 들어서는 데이터가 그래서 어떻게 구성되어 있는지 전혀 와닿지가 않음
4.3 Variant Effect Prediction of coding Non-SNVs
Non-SNVs 란 말은 SNV이 아닌, 다시말해 하나의 유전자 내에 2개 이상의 위치에서 변이가 있는 경우를 말한다.
데이터는 ClinVar로부터 얻어졌으며, SNVs의 수는 64개 이하인 것만 필터링하였고, 최소한 Review Status가 별 2개 이상(여러 연구에서 반복적으로 보고된 변이) 인 것들만 사용하였다. 그 이후는 4.2와 유사하게 GPT-4o 버전을 이용해서 각 샘플별로 50개의 Question을 만들어 Q-A 쌍을 구축하고 train/valid 데이터로 사용하였다.
5. Expreiments
5.1 Datasets
- KEGG-Derived Biological Reasoning Dataset (Mutation Effect CoT Reasoning 평가 + 관련 Final Answer로 Disease 예측)
- Variant Effect Prediction of Coding Sequences (SNVs이 Pathogenic인지 Benign인지 classification)
- Variant Effect Prediction of Coding Non-SNVs (Non-SNVs이 Pathogenic인지 Benign인지 classification)
5.2 Baseline 모델들은 DNA Foundation 모델과 LLM 모델을 각각 사용하였다.
DNA Foundation 모델은 Evo2-1B와 Nucleotide Transformer 500M 모델을 사용했고, LLM Baseline으로는 Qwen3.0-1.7B와 Qwen3.0-4B 모델을 사용했다. DNA Foundation 모델의 경우는 보통 representation vector만 뱉어내기 때문에 Attention head를 이용해서 모든 토큰들의 정보를 통합한 하나의 Final representation vector를 얻고, Multiclass classification을 학습할 수 있도록 뒷단을 수정했을 가능성이 높다.
평가는 BIOREASON, LLM only, DNA Foundation Only 이렇게 세가지 모델으로 진행되고, BIOREASON같은 경우는 LLM과 DNA Foundation 모델을 모두 사용해야 하므로 조합된 형태로 이뤄진다. GRPO 추가 강화학습이 진행된 모델도 결과에 추가되어있다.
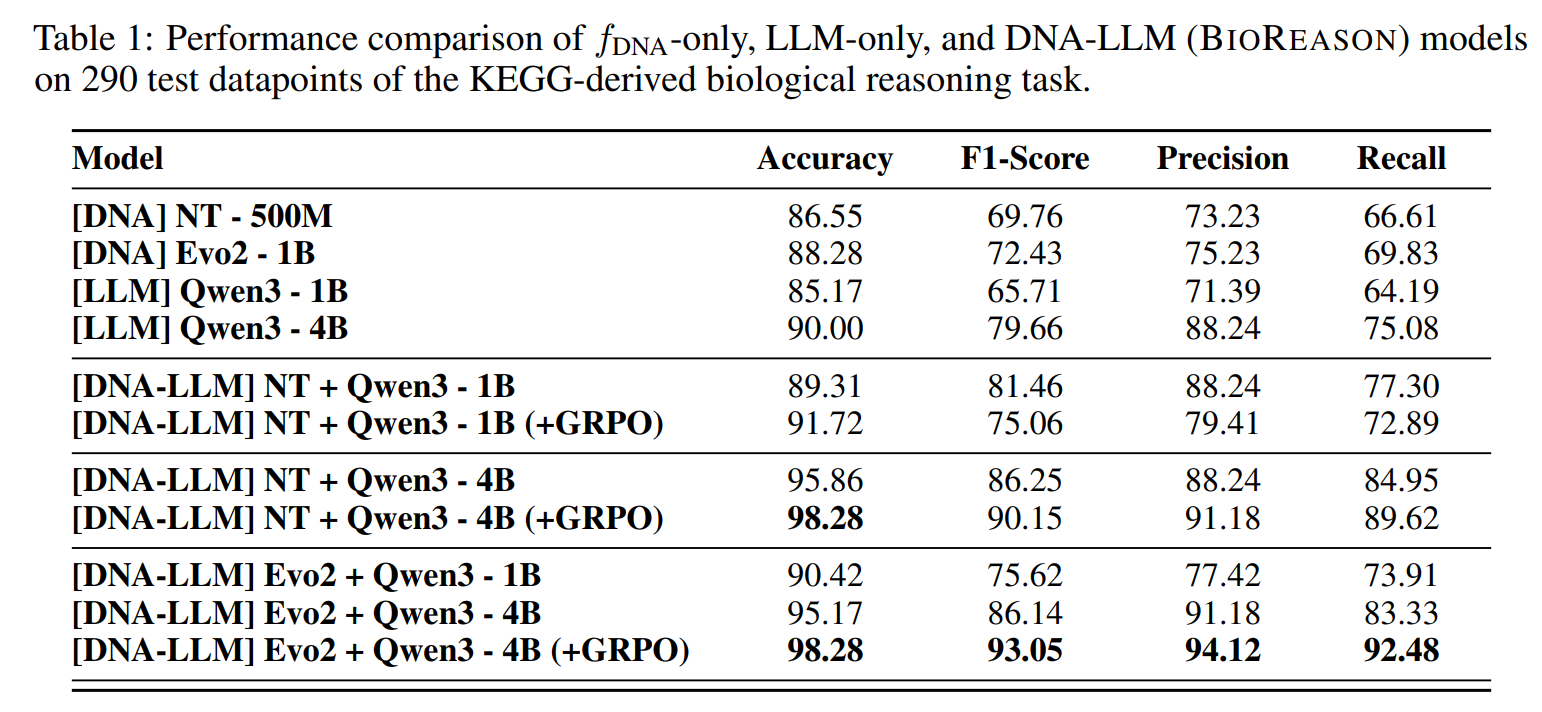
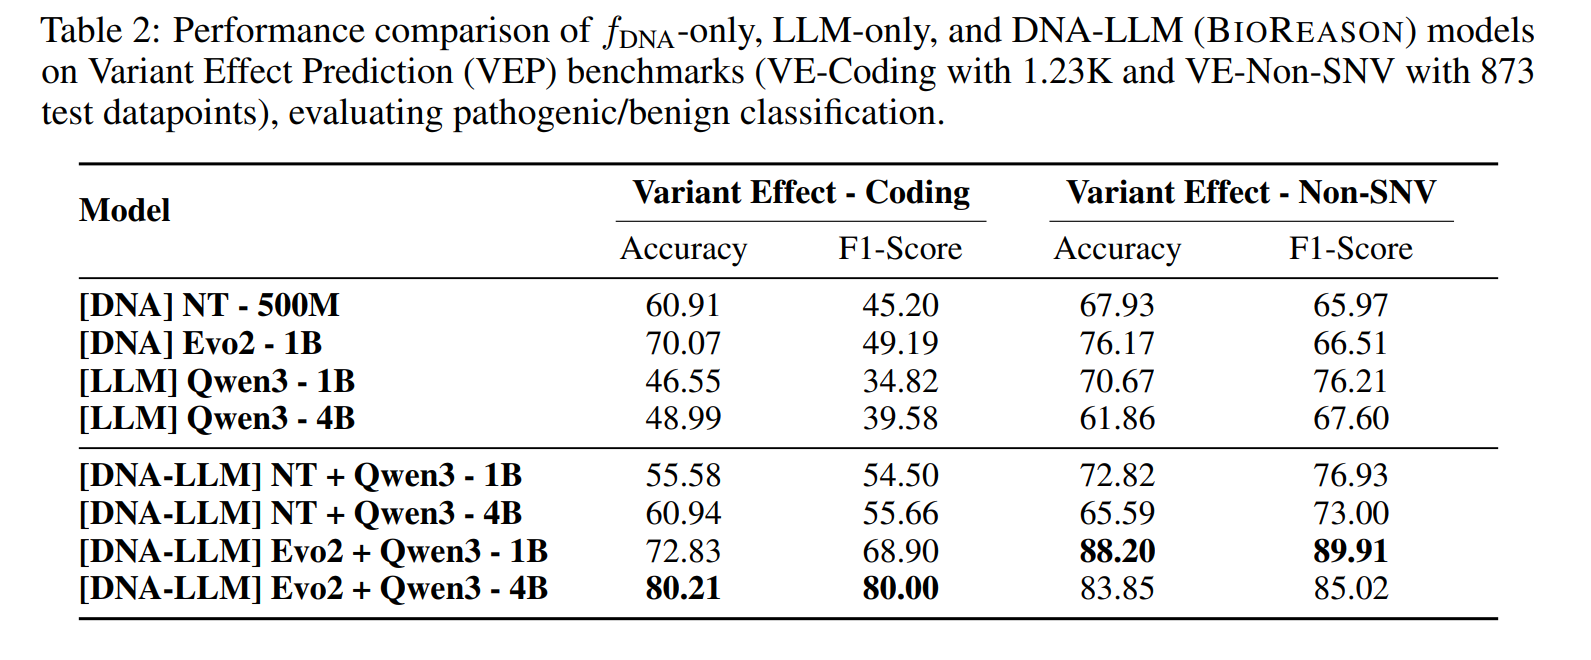
해석할 건 따로 없어보이니 넘어가고, 마지막으로 Case study도 하나 넣어놓았는데 솔직히 바이오 분야의 Case Study는 대부분 그냥 여러가지 Case를 막무가내로 Inference 시켜보다가 해석하기 가장 유리하게 나온 결과 하나를 선택해서 가져다 넣는 경우가 대부분이라 큰 의미는 없어보인다.
정리 및 논문에서 착안할 점
본 연구는 Reasoning을 가장 중요한 Main contribution으로 삼았으나 정작 Reasoning 정확성, 그 자체는 평가하지 않았으며, 단순히 질병 결과인 Final Disease만을 예측하는 Binary 또는 Multiclass Classification 결과만을 평가항목으로 제시했다는 점은 단점인 것 같다.
또한 학습용 데이터를 구축하는 과정에서 생물학 분야에 맞춰 최적화되지 않고 적절한 생물학 배경의 DB를 탐색 및 사용하지 못하는 Naive한 형태의 클로드, GPT-4o API를 사용해서 Q-A 쌍을 만들었기 때문에 학습할 Q-A 쌍의 퀄리티가 좋을지 의심되며 앞서 말한 것과 동일하게, 실제로 생성된 Q-A쌍의 step-by-step의 설명이 과연 얼마나 정확하게 생성되었는지에 대한 평가가 없다는 것은 분명한 단점같다.
Q-A쌍을 만드는 방식을 RAG를 이용해서 생물학 DB를 직접 탐색할 수 있는 형태의 LLM 에이전트를 사용해서 Q-A쌍의 퀄리티를 높이는 방법을 고려해보면 좋을 것 같고, 단순한 Final Disease Classification뿐 아니라, Reasoning 과정에서 생성된 step별 문장들의 의미를 단계별로 평가할 수 있는 방법도 제시하면 더 좋을 것 같다.
여기에 추가 아이디어가 있어서 한번 아이디어 구체화를 해보고 ACL에 한번 투고해 볼 생각이다.
[1] F. I. Marin, F. Teufel, M. Horlacher, D. Madsen, D. Pultz, O. Winther, and W. Boomsma. Bend: Benchmarking dna language models on biologically meaningful tasks. 12th International Conference on Learning Representations, ICLR 2024, 11 2023. URL https://arxiv.org/ pdf/2311.12570.
[2] Genome modeling and design across all domains of life with evo 2. bioRxiv, 2025. doi: 10.1101/2025.02.18.638918. URL https://www.biorxiv.org/content/early/2025/02/21/2025.02.18.638918.
[3] Nucleotide transformer: building and evaluating robust foundation models for human genomics. Nature Methods, 22(2):287–297, Feb. 2025. ISSN 1548-7091, 1548-7105. doi: 10.1038/s41592-024-02523-z. URL https://www.nature. com/articles/s41592-024-02523-z.
[4] Roformer: Enhanced transformer with rotary position embedding, 2023. URL https://arxiv.org/abs/2104.09864.
[5] kegg pull: a software package for the restful access and pulling from the kyoto encyclopedia of gene and genomes. BMC Bioinformatics, 24:1–17, 12 2023. ISSN 14712105. doi: 10.1186/S12859-023-05208-0
[6] J. Kans. Entrez direct: E-utilities on the unix command line - entrez programming utilities help - ncbi bookshelf, 4 2013. URL https://www.ncbi.nlm.nih.gov/books/NBK179288/.